Modelagem dimensional para marketing analytics: star schema na prática
Dashboard bonito em cima de modelo errado é o cenário mais caro de analytics de marketing: números batem internamente, stakeholders confiam, e a decisão de budget vai para o canal errado. Star schema não é exercício acadêmico — é a forma de garantir que spend, sessão, lead e receita coexistam na mesma granularidade sem duplicar fatos ou misturar dimensões incompatíveis. Modelagem dimensional bem feita antecipa a pergunta do BI antes que o analista precise inventar join na hora do meeting.
O que é star schema e por que marketing precisa dele?
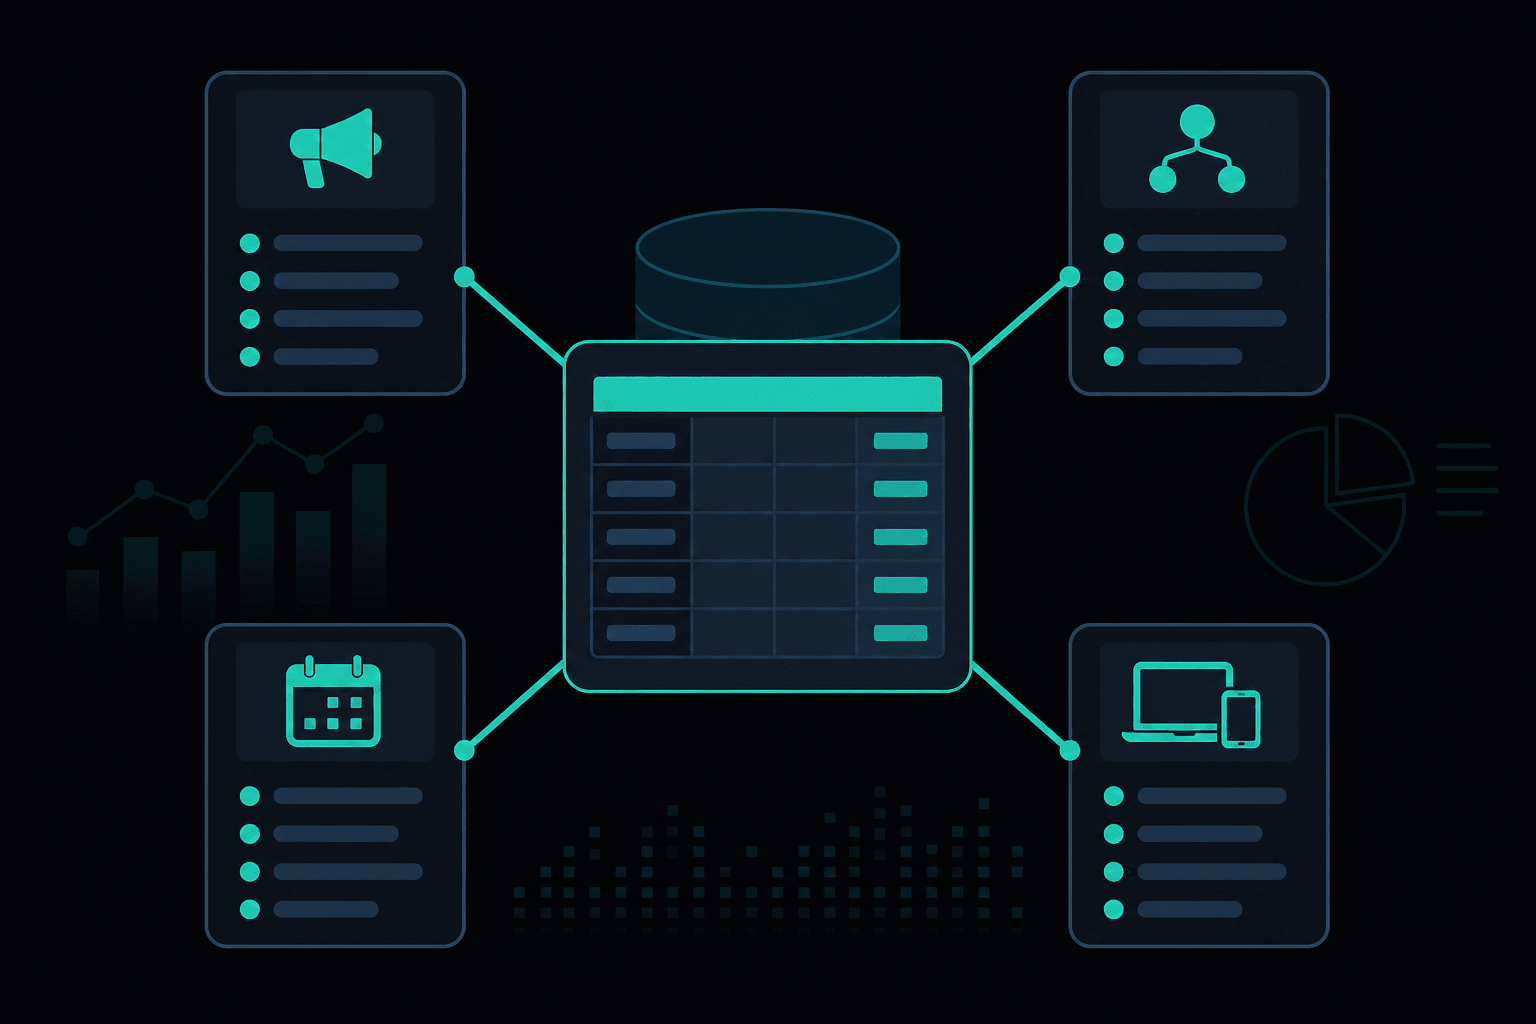
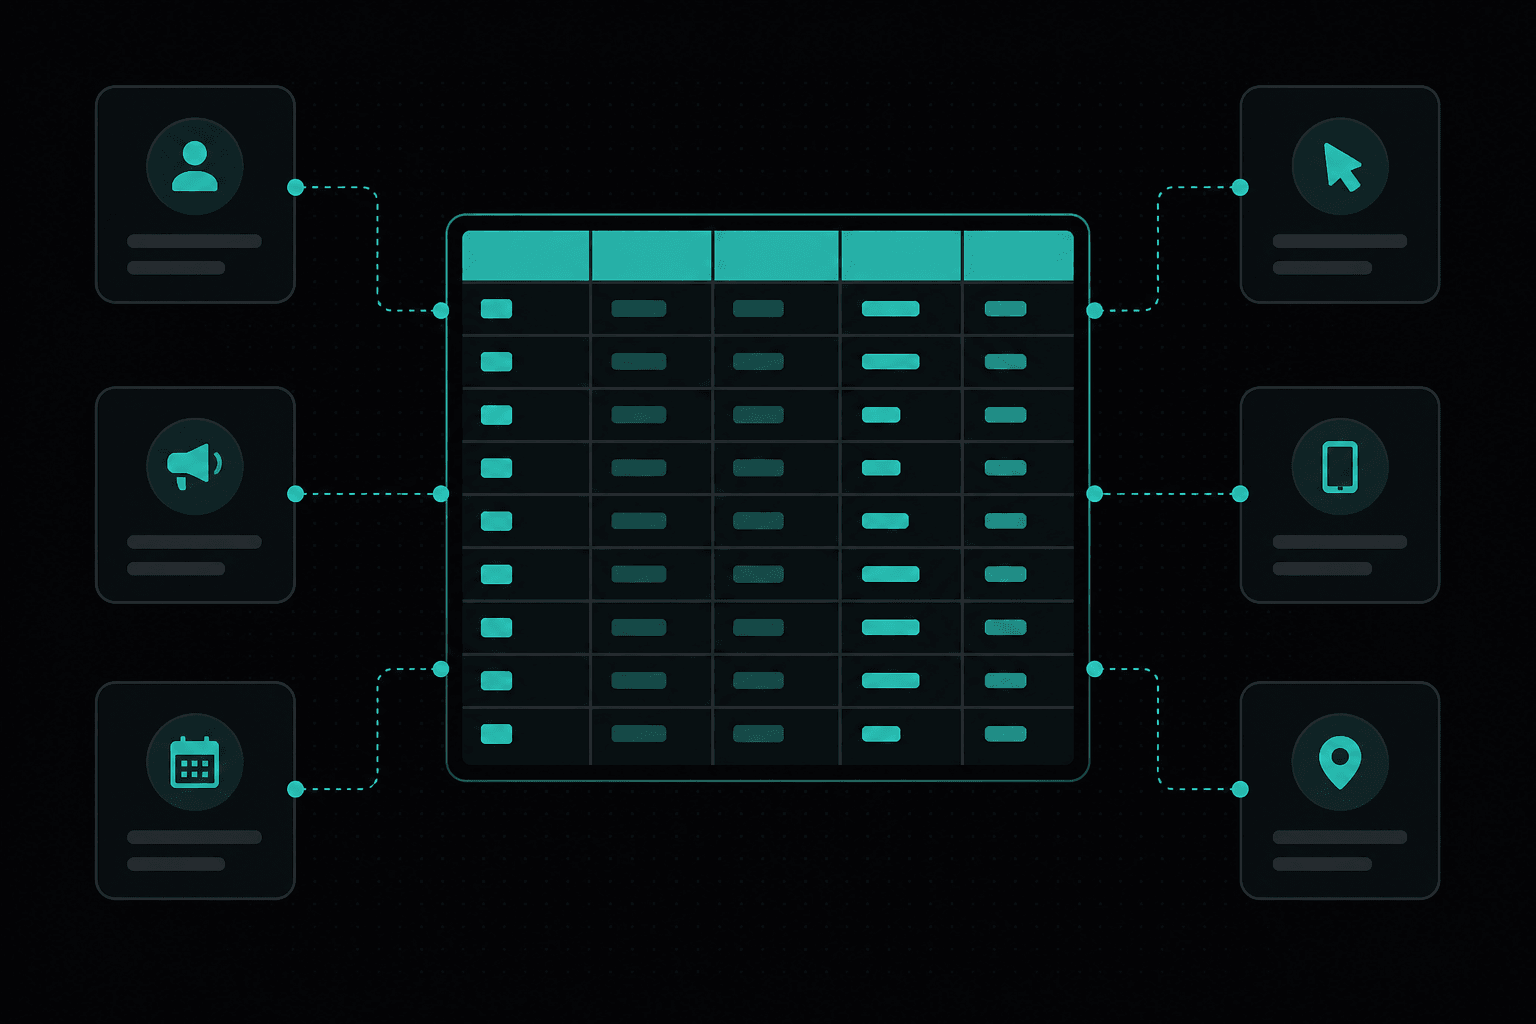
Star schema organiza dados em uma tabela de fatos central — eventos mensuráveis como impressões, cliques, sessões, leads ou receita — rodeada por dimensões descritivas: data, campanha, canal, dispositivo, produto, região. A estrutura em estrela simplifica joins previsíveis, acelera queries de BI e reduz ambiguidade sobre o que está sendo somado.
Marketing vive de cruzamentos: ROAS por campanha, CPL por canal, conversão por landing page, receita por cohort de aquisição. Sem modelo dimensional, cada cruzamento vira SQL ad hoc com risco de cartesian product, double counting ou grain mismatch. O star schema força a conversa sobre granularidade antes do dashboard ir ao ar.
Como definir a granularidade da tabela de fatos?
A granularidade é a unidade mínima de uma linha na fato: uma linha por impressão, por clique, por sessão, por lead ou por pedido. A escolha depende das perguntas de negócio e do custo de storage/processamento. Fatos diários agregados por campanha servem para reporting executivo; fatos em nível de evento servem para funis e atribuição fina.
O erro clássico é misturar grains na mesma tabela — somar impressões com cliques na mesma linha, ou juntar sessão com transação sem regra de cardinalidade. Documente o grain em linguagem de negócio: ‘cada linha representa uma sessão iniciada no site, atribuída à última campanha non-direct click’. Qualquer métrica derivada deve respeitar esse contrato.
- Grain documentado em uma frase de negócio, não só técnica
- Métricas aditivas vs semi-aditivas vs não-aditivas identificadas
- Surrogate keys nas dimensões para joins estáveis
- Degenerate dimensions (order_id, session_id) quando necessário
- Decisão explícita sobre snapshot vs transactional fact
Quais dimensões são obrigatórias em marketing analytics?
Dim_date é universal: permite YoY, WoW, sazonalidade e alinhamento com calendário fiscal. Dim_campaign ou dim_utm captura origem de mídia com hierarquia account > campaign > ad group > ad. Dim_channel agrupa plataformas em categorias de negócio (paid search, paid social, organic, email). Dim_device, dim_geo e dim_landing_page completam a maioria dos breakdowns operacionais.
Dimensões de produto, cliente e conta entram quando marketing cruza com CRM ou e-commerce. A regra é: se o stakeholder filtra ou segmenta por um atributo com frequência, ele merece dimensão — não parâmetro solto em JSON. Dimensões lentamente mutáveis (SCD Type 2) são necessárias quando atributos históricos importam, como mudança de segmento de cliente ou reclassificação de campanha.
| Dimensão | Atributos típicos | Fonte comum | Armadilha |
|---|---|---|---|
| dim_date | data, semana, mês, trimestre, feriado | Calendário gerado | Timezone inconsistente entre fontes |
| dim_campaign | campaign_id, nome, canal, objetivo, budget | Ads APIs, UTM | Naming caótico sem governança |
| dim_channel | canal, subcanal, paid/owned/earned | Regra de negócio + UTM | Classificação manual não versionada |
| dim_device | device category, OS, browser | GA4, user-agent | Cardinalidade alta demais no BI |
| dim_customer | segmento, tier, região, cohort | CRM, CDP | SCD mal implementado distorce histórico |
Como modelar spend de mídia junto com comportamento web?
Spend de ads e sessões/conversões do GA4 vivem em grains diferentes: spend é diário por entidade de campanha; sessões são por usuário/dispositivo com atribuição probabilística. A ponte é dim_campaign (ou dim_ad) com chave comum e uma fato de spend separada da fato de sessões/conversões. Juntar tudo numa única fato wide é tentador e quase sempre quebra reconciliação.
Para ROAS e CPA, agregue ambas as fatos na grain de campanha + data antes de calcular ratio. Métricas derivadas como ROAS não são aditivas — somar ROAS de duas campanhas não faz sentido. O modelo dimensional deixa isso explícito: numerador e denominador vêm de fatos compatíveis, ratio calculado na camada semântica ou no BI com regra documentada.
Snowflake schema vs star schema: quando complicar?
Star schema mantém dimensões flat — todos os atributos na mesma tabela. Snowflake schema normaliza dimensões em sub-tabelas (ex.: dim_product → dim_category → dim_brand). Para marketing analytics, star flat costuma vencer: queries mais simples, BI mais rápido de configurar, menos joins para o analista.
Snowflake faz sentido quando dimensões são enormes, compartilhadas entre múltiplos assuntos de negócio, ou quando governança exige normalização estrita. Mid-market de marketing raramente precisa — o risco de over-engineering supera o benefício. Prefira star com dimensões bem desenhadas e views semânticas para abstrações complexas.
Quais erros de modelagem quebram dashboards silenciosamente?
Fan trap e chasm trap ocorrem quando joins entre dimensões e fatos multiplicam linhas inadvertidamente — receita dobra, CPA cai pela metade, ninguém percebe até alguém reconciliar com a plataforma de ads. Many-to-many sem bridge table é outro clássico: campanha ligada a múltiplos produtos sem tabela associativa.
Dimensões com grain mais fino que a fato também distorcem: juntar fato diária de spend com dim_creative que muda de nome intraday gera duplicatas. Teste de sanidade obrigatório: total de spend no modelo = total na plataforma de ads; total de conversões = total no GA4/CRM para a mesma janela e definição.
- Reconciliação automática spend plataforma vs warehouse
- Teste de unicidade na grain da fato
- Validação de cardinalidade em joins críticos
- Documentação de métricas aditivas vs ratios
- Alerta quando totais divergem além de threshold
Como evoluir o modelo sem quebrar histórico?
Mudanças de grain ou de definição de dimensão são breaking changes — trate como versionamento de API. Adicione colunas nullable antes de deprecar antigas; mantenha views de compatibilidade por um ciclo de reporting. Quando reclassificar canal ou campanha retroativamente, use SCD Type 2 ou tabela de override com effective_date.
dbt, documentação inline e testes de schema ajudam a evoluir com confiança. Cada PR que altera grain ou join deve incluir query de reconciliação antes/depois. Marketing muda nomenclatura de campanha toda semana — o modelo precisa absorver isso sem exigir redesign mensal.
Checklist prático
- Grain da fato documentado em linguagem de negócio
- Dimensões core: date, campaign, channel, device mapeadas
- Spend e conversões em fatos separadas com ponte dimensional
- Métricas aditivas vs ratios classificadas e documentadas
- Reconciliação automática com plataformas de origem
- Testes de unicidade e cardinalidade nos joins críticos
- SCD Type 2 onde atributos históricos importam
- Processo de change management para alterações de grain
Erros comuns
- Misturar impressão, clique e conversão na mesma linha de fato
- Somar ROAS ou CPA como se fossem métricas aditivas
- Ignorar timezone na dim_date e distorcer reporting diário
- Criar dimensão com cardinalidade ilimitada (ex.: URL completa)
- Join many-to-many sem bridge table
- Mudar grain da fato sem versionar dashboards dependentes
Dashboard bonito em cima de modelo errado?
A DataScroll desenha modelos dimensionais para marketing com fatos, dimensões e governança — para BI refletir o negócio.