Identity resolution: unificar usuário cross-device sem ilusão
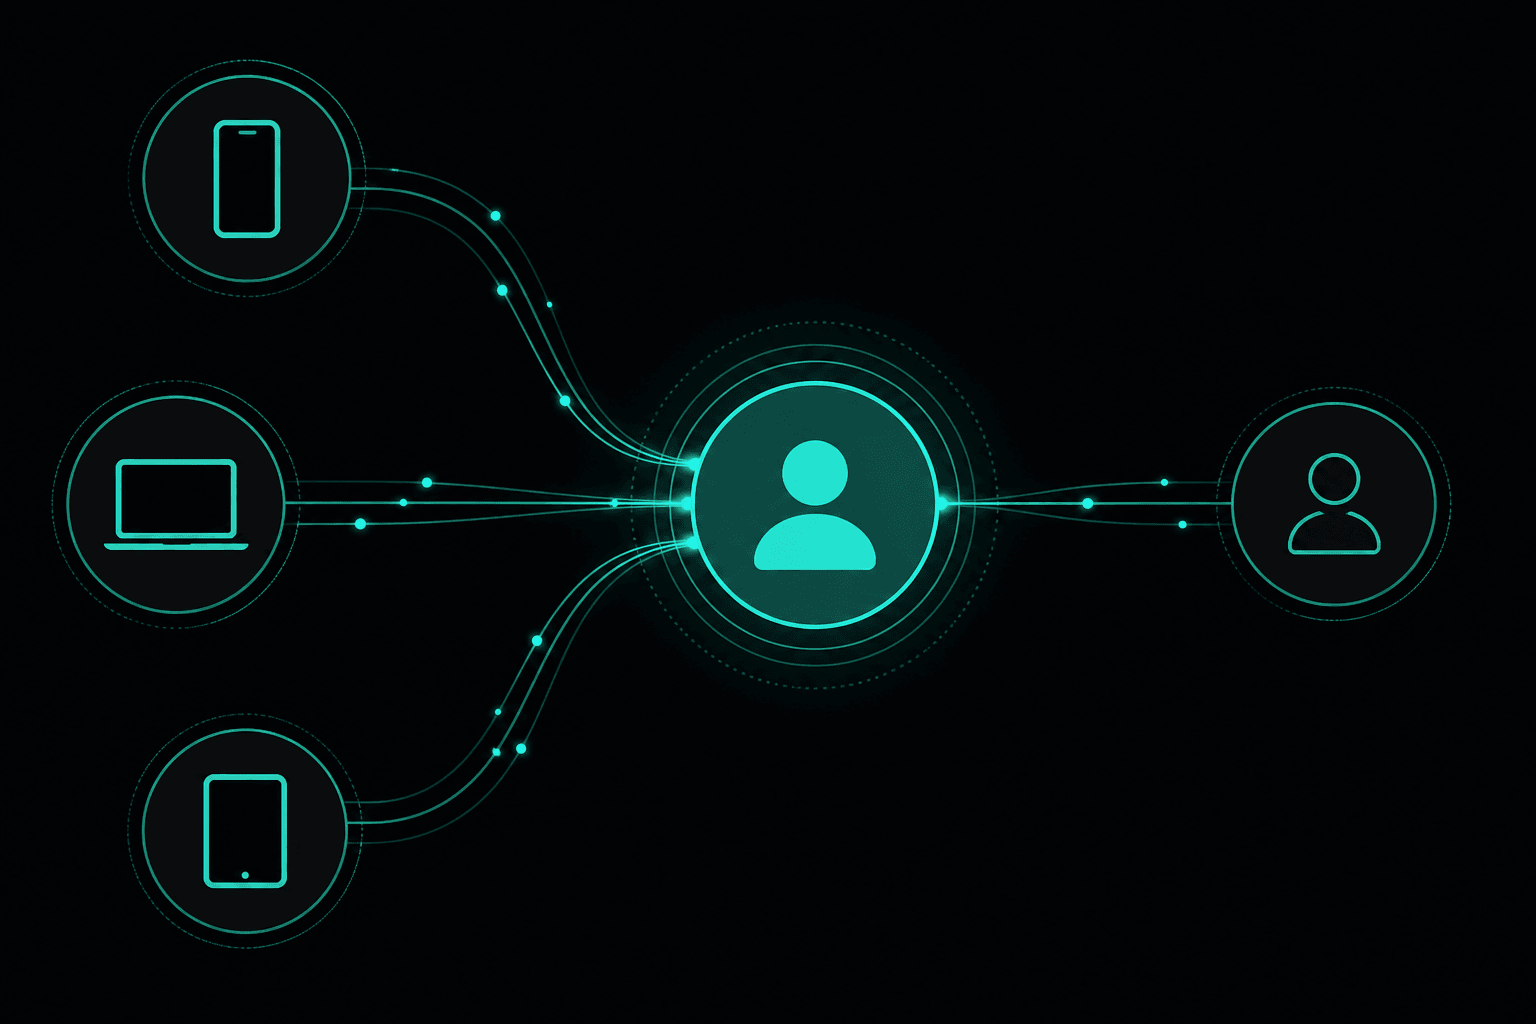
Usuário único cross-device é promessa sedutora e realidade parcial: login unifica identidade; probabilístico infere com erro; device graph de vendor vende certeza que dados raramente sustentam. Identity resolution honesta define o que é possível com os identificadores disponíveis — user_id, device_id, e-mail hash, CRM id — e comunica limites antes que stakeholder interprete gráfico perfeito como verdade absoluta.
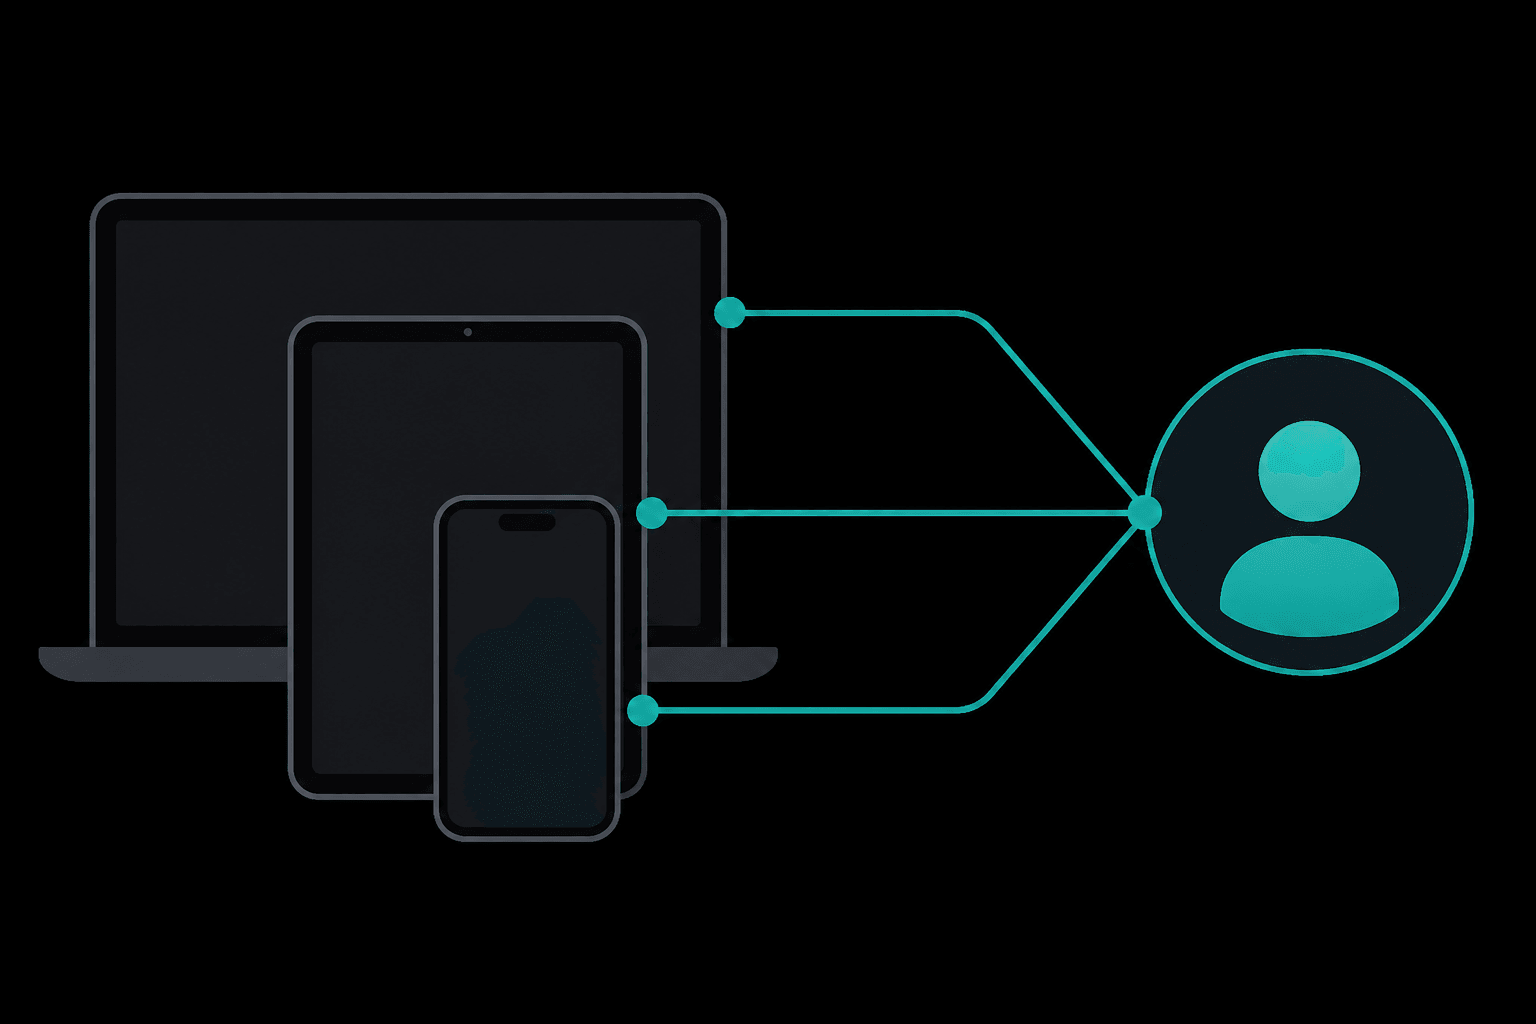
O que é identity resolution e o que não é?
Identity resolution é o processo de reconhecer que múltiplos identificadores (cookies, device IDs, user_ids, e-mails) pertencem à mesma pessoa ou household. Output é identity graph: nós (identificadores) conectados por arestas (links determinísticos ou probabilísticos).
Não é: tracking perfeito cross-device anônimo; substituto de login; milagre pós-cookie apocalypse. É maximizar visão unificada dentro de limites legais, técnicos e de consentimento — com taxa de match documentada.
Determinístico vs probabilístico: diferença prática?
Determinístico: mesmo identificador exato em dois contextos — user_id no mobile e web após login; e-mail hash igual em CRM e analytics; gclid persistido. Match rate alto (>90% entre logados), baixo false positive. Limitado a usuários autenticados ou identificados.
Probabilístico: inferência por sinal comportamental — mesmo IP, user-agent, padrão de navegação, localização. Match rate variável (30-60%), false positives existem. Vendors (LiveRamp, The Trade Desk) vendem graphs probabilísticos; qualidade varia. Use para audiência e reach estimation — não para atribuição precisa de receita.
- Determinístico: user_id, email_hash, CRM id
- Probabilístico: IP+UA, behavioral fingerprint
- Híbrido: determinístico onde possível, probabilístico como fill
- Documentar match rate por método
- Nunca apresentar probabilístico como ground truth
Quais identificadores marketing tem na prática?
Anônimo: client_id/user_pseudo_id (GA4 cookie), device advertising ID (declinante), session IDs. Autenticado: user_id setado pós-login, account_id em B2B. CRM: e-mail (hash), lead_id, customer_id. Ads: gclid, fbclid, campaign click IDs.
First-party data é o ativo: quanto mais login, newsletter signup e conta criada, melhor identity resolution determinística. Produto que não exige login terá visão fragmentada — aceite e meça % unidentified.
| Identificador | Escopo | Persistência | Cross-device |
|---|---|---|---|
| user_pseudo_id (GA4) | Browser/app instance | Cookie 24m max | Não |
| user_id | Conta autenticada | Permanente se login | Sim, cross-browser |
| email_hash | CRM + CAPI | Permanente | Sim, com login/email |
| gclid/fbclid | Sessão de click | Dias (varia) | Não |
| device_id (IDFA/GAID) | Device | Até opt-out/reset | Não cross-ecosystem |
Como implementar identity graph no warehouse?
Modelo hub-and-spoke ou graph table: identity_graph(user_id, anonymous_id, email_hash, source, first_seen, last_seen, link_type). Regras de merge: quando user_id aparece com anonymous_id, criar link determinístico. Propagação: todos eventos do anonymous_id herdam user_id para análises downstream.
Implemente em dbt com SCD: links podem ser invalidados (logout, merge errado). Mantenha canonical_user_id como surrogate. Funis e LTV calculam sobre canonical — não sobre device fragmentado.
Quais casos de uso justificam identity resolution?
Atribuição cross-device: viu ad no mobile, comprou no desktop — sem stitch, conversão vai para direct. LTV e cohort por origem real do usuário, não por device. Frequency cap e deduplicação de audiência. Personalização cross-channel com consent.
Não justifica sozinho: vanity metric de ‘usuários únicos’ inflado para slide. Se decisão não muda com vs sem stitch, invista em qualidade de tagueamento primeiro.
Quais limites honestos comunicar?
Match rate: ‘unificamos 45% dos usuários cross-device via login; 55% permanecem device-level’. Consent: usuários que negaram tracking não entram no graph. Latência: stitch acontece no login — jornada pré-login permanece anônima. Probabilístico: ‘audiência estimada ±15%’.
Regulatório: LGPD/GDPR exigem base legal para link de identificadores. Não faça graph de PII sem consent e política clara. Documentação para auditoria.
- Match rate publicado internamente
- % unidentified como KPI de produto
- Consent flags respeitados no graph
- Probabilístico rotulado como estimativa
- Base legal documentada para LGPD
CDP vs identity resolution no warehouse?
CDP (Segment, mParticle, Rudderstack) oferece identity resolution managed, profiles unificados e ativação. Warehouse-first: você constrói graph em dbt, CDP ou reverse ETL ativa. CDP faz sentido com múltiplos destinos de ativação e time sem engenharia; warehouse faz sentido com analytics engineer e controle total.
Híbrido comum: CDP para collect + identity básica; warehouse enriquece com CRM e modela graph completo. Evite dois graphs conflitantes — declare canonical source.
Checklist prático
- Identificadores disponíveis mapeados (anonymous, user_id, CRM)
- Estratégia determinístico vs probabilístico definida
- Identity graph modelado no warehouse ou CDP
- Match rate medido e documentado
- % unidentified tracked como KPI
- Consent e LGPD respeitados no linking
- Canonical user_id para funis e LTV
- Limites comunicados aos stakeholders
Erros comuns
- Prometer cross-device perfeito sem login
- Probabilístico apresentado como ground truth
- Dois identity graphs conflitantes (CDP + warehouse)
- Ignorar consent na união de identificadores
- Stitch agressivo gerando false merges
- Investir em identity graph antes de tagueamento básico funcionar
Usuário único inflado ou fragmentado?
A DataScroll desenha identity resolution proporcional ao dado disponível — sem prometer gráfico perfeito impossível.