dbt para marketing: transformações confiáveis e testáveis
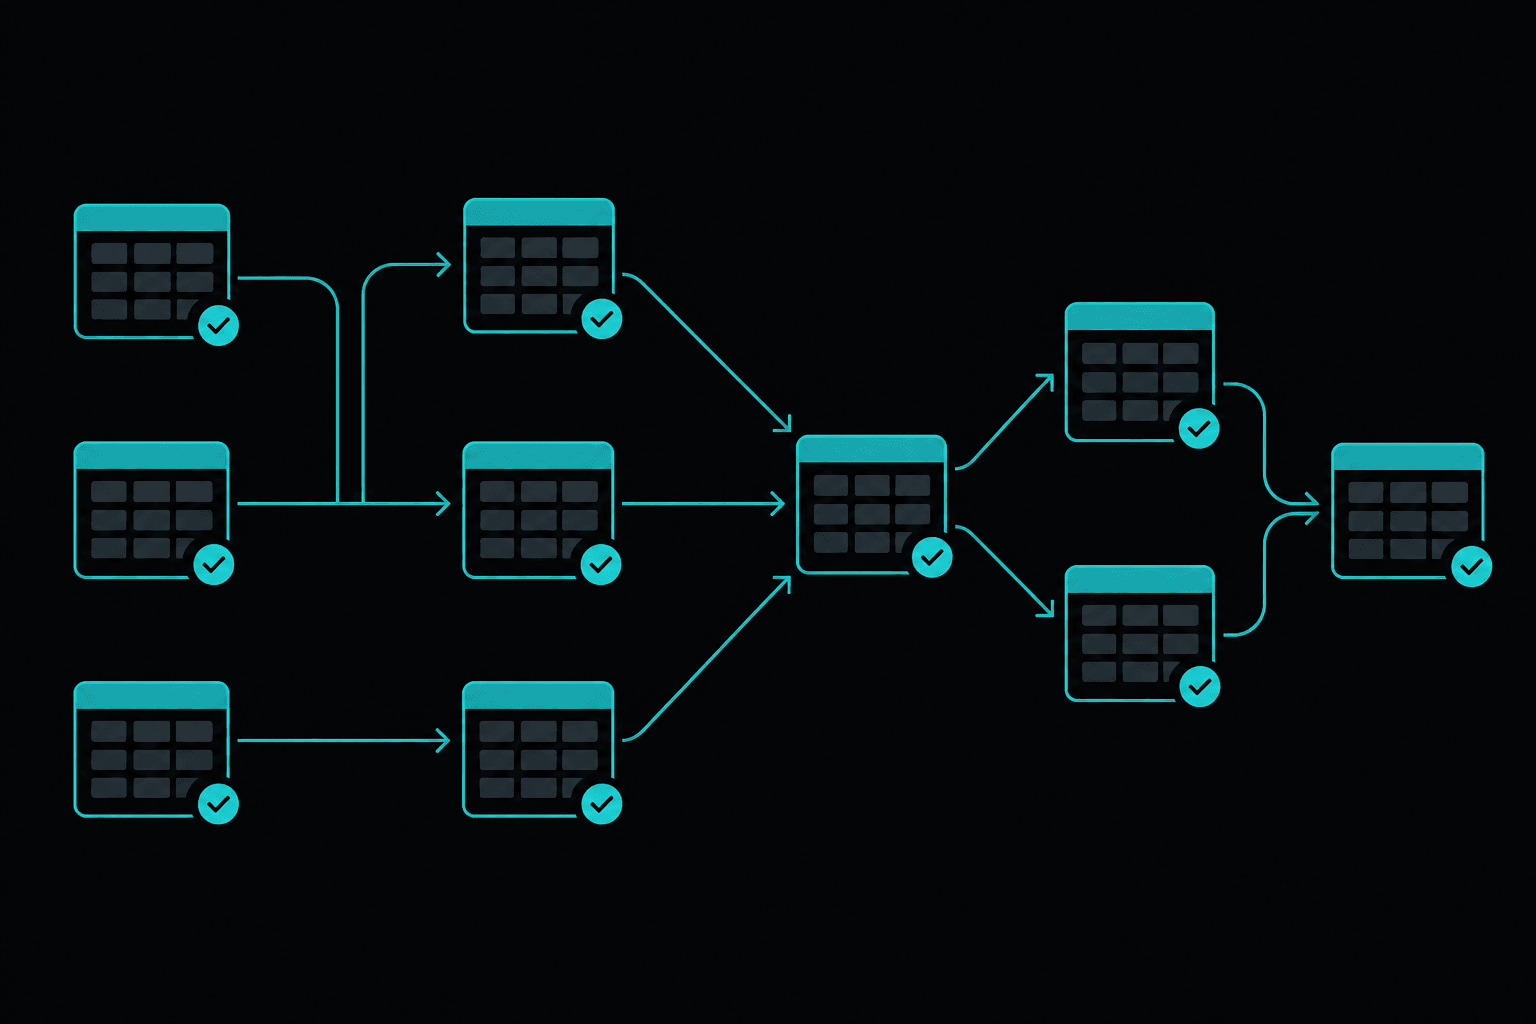
SQL espalhado em planilhas intermediárias, pastas compartilhadas e cabeça de analista que saiu da empresa não é pipeline — é dívida técnica com juros compostos. dbt transforma transformações de marketing em código versionado, testável e documentado: models de spend, sessões, conversões e atribuição com lineage visível e alerta quando algo quebra. Não é ferramenta de moda; é a camada de confiança entre raw data e dashboard que stakeholder usa para decidir budget.
O que dbt resolve especificamente para marketing?
dbt (data build tool) gerencia transformações SQL no warehouse como software: models em arquivos .sql, dependências declaradas, testes automatizados, documentação gerada e execução orquestrada. Para marketing, substitui a cadeia de ‘export CSV → VLOOKUP → pivot → dashboard’ por pipeline reproduzível.
Casos concretos: model de spend unificando Google/Meta/LinkedIn; model de sessões GA4 com sessionization custom; model de conversões cruzando web + CRM; model de atribuição first/last touch. Cada um versionado, testado e com owner claro.
Como estruturar projeto dbt para analytics de marketing?
Organize por camadas: staging (stg_google_ads__, stg_ga4__, stg_hubspot__) com limpeza técnica; intermediate (int_sessions, int_campaigns_unified) com joins e lógica de negócio; marts (fct_spend, fct_conversions, dim_campaign) prontos para BI. Prefixos consistentes evitam caos.
Separe por domínio se o projeto crescer: models/marketing/, models/crm/, models/product/. Marketing ops precisa encontrar fct_ad_performance sem vasculhar 200 arquivos. Documente cada model com description no schema.yml — futuro você agradece.
- staging: 1:1 com source, rename e cast only
- intermediate: joins cross-fonte, dedupe, sessionization
- marts: star schema, grain documentado
- schema.yml com descriptions e tests por model
- Naming: stg_, int_, fct_, dim_ prefixos fixos
Quais testes dbt importam para dados de marketing?
unique e not_null na grain da fato — duplicata de sessão ou lead infla conversão. accepted_values em dim_channel — valor fora da taxonomia indica bug de classificação. relationships entre fato e dimensão — orphan records quebram join silenciosamente. freshness no source — dado de ontem que não chegou.
Testes customizados são ouro: assert spend warehouse = spend Google Ads API (tolerância 1%); assert conversion count >= 0; assert session count não cai >30% day-over-day sem explicação. Testes de reconciliação valem mais que dezenas de not_null.
| Teste | Alvo | O que detecta | Prioridade |
|---|---|---|---|
| unique | session_id, lead_id na fato | Duplicatas que inflam métricas | Crítica |
| not_null | campaign_id, event_date | Registros incompletos | Crítica |
| accepted_values | channel, device_category | Classificação fora da taxonomia | Alta |
| relationships | fct → dim_campaign | Orphans que somem no BI | Alta |
| freshness | sources de ads/GA4 | Pipeline atrasado | Crítica |
Incremental vs table materialization: quando usar?
Table (full refresh): models pequenas, dimensões, ou quando lógica exige reprocessar tudo. Incremental: fatos de eventos (GA4), spend diário, logs — append ou merge de novos dados sem reprocessar histórico. GA4 raw com bilhões de rows exige incremental obrigatoriamente.
Estratégia merge (upsert) para dados que atualizam (CRM deals mudam stage); append para eventos imutáveis (cliques, sessões). Configurar incremental_strategy errado gera duplicatas ou perda de dados — teste com janela pequena antes de produção.
Como documentar e gerar lineage útil?
schema.yml com description de cada model e coluna em linguagem de negócio — ‘Receita atribuída à campanha por last non-direct click, grain diária’. dbt docs generate produz site navegável com lineage graph. Quando stakeholder pergunta ‘de onde vem ROAS?’, aponte para o graph.
Exposures conectam models a dashboards Looker/Metabase — impacto de mudança fica visível. Se alterar int_sessions, veja quais dashboards quebram antes do deploy. Lineage não é luxo; é seguro de vida quando marketing depende do número.
dbt Cloud vs Core vs coalesce com Airflow?
dbt Core (open source): roda local ou CI, grátis, exige orquestrador externo (Airflow, GitHub Actions). dbt Cloud: scheduling, IDE, alerts, docs hosting — $100+/seat/mês, menor friction para times pequenos. Coalesce com Airflow/Prefect: controle total, custo de ops maior.
Mid-market: dbt Cloud se budget permite e time <5 pessoas; Core + GitHub Actions se engenharia madura. Não complique orquestração antes de ter 20+ models — cron job simples basta no início.
- Comece com dbt Core + git + CI simples
- dbt Cloud quando scheduling/alerts virarem gargalo
- Airflow para dependências cross-domínio (ads sync → dbt run)
- Slim CI: testar só models afetados por PR
- Artifacts de run salvos para debug
Quais erros comuns ao implementar dbt em marketing?
Copiar SQL legado sem refatorar — vira monólito inmanutenível. Zero testes de reconciliação — confiança cega. Models god-table com 80 colunas — ninguém entende grain. Não usar incremental em GA4 — bill shock garantido. Documentação vazia — próximo analista recomeça do zero.
Outro erro: dbt virar responsabilidade de engenharia distante de marketing. Analytics engineer (ou analista sênior) precisa entender campanha, atribuição e conversão — senão models tecnicamente corretos respondem perguntas erradas.
Checklist prático
- Projeto dbt estruturado em staging/intermediate/marts
- Naming convention documentada (stg_, fct_, dim_)
- Testes unique/not_null na grain de cada fato
- Reconciliação spend e conversões com fontes
- Models incrementais para GA4 e eventos
- schema.yml com descriptions de negócio
- dbt docs publicado e acessível ao time
- CI rodando tests em PR antes de merge
Erros comuns
- Full refresh diário de tabela GA4 com bilhões de rows
- SQL legado copiado sem decomposição em models
- Zero testes de reconciliação com plataformas
- Documentação vazia ou só nomes técnicos
- Grain ambíguo em models de conversão/atribuição
- dbt mantido por engenharia sem entender contexto de marketing
SQL espalhado sem teste nem doc?
A DataScroll implementa dbt com testes e documentação para transformações de marketing serem confiáveis.