Monitoramento de tags com alertas: pare de descobrir quebrado tarde
Tag quebrada raramente aparece como erro vermelho no GTM — ela aparece como conversão zerada, ROAS inflado ou campanha “otimizando” para silêncio. Monitoramento de tags com alertas transforma analytics ops de auditoria reativa (fim do mês) em rotina que detecta regressão em horas. O segredo não é monitorar “tudo”: é definir sinais de volume, conversão e integridade que refletem risco real de decisão errada.
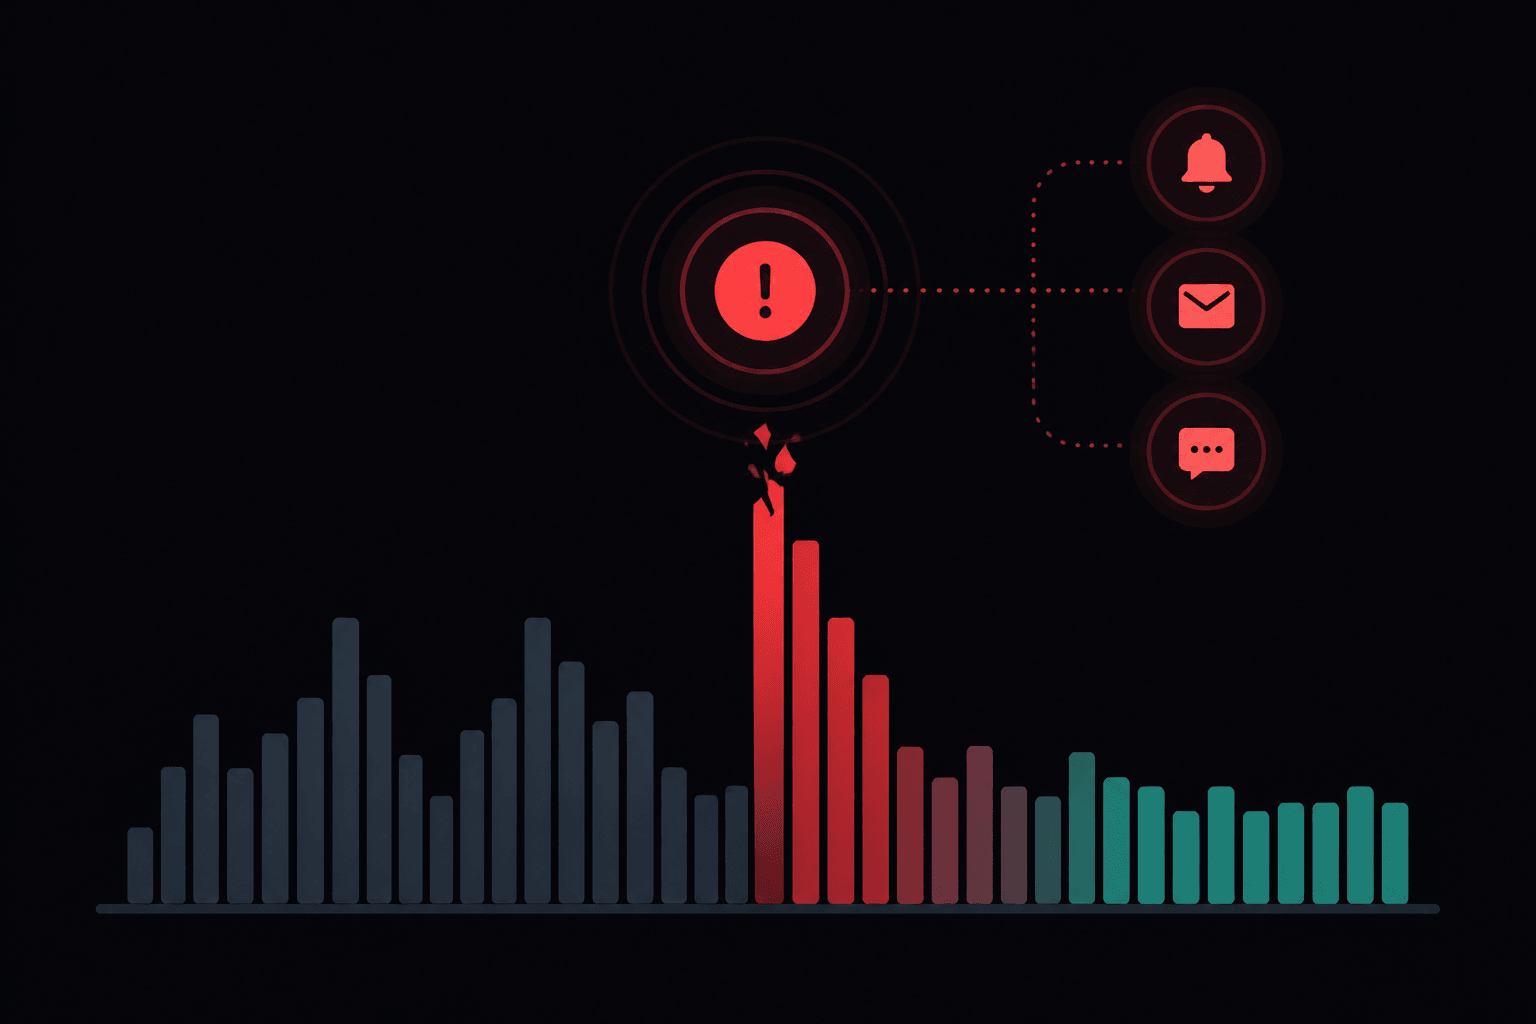
Por que monitoramento de tags não pode ser só QA manual?
QA manual (Preview, Tag Assistant, checklist pós-deploy) é necessário, mas não escala com releases frequentes, A/B de layout, CMP que muda consent e terceiros que quebram silenciosamente. Um analista que só testa após publicação descobre o buraco quando o budget já rodou ou o relatório executivo já foi apresentado.
Monitoramento contínuo compara o comportamento esperado do tagueamento com o observado: volume de eventos-chave, taxa de conversão por funil, presença de parâmetros obrigatórios e deltas pós-release. O objetivo não é provar perfeição — é detectar desvio estatisticamente relevante antes da decisão de negócio.
Quais sinais merecem alerta automático?
Priorize eventos ligados a receita e otimização de mídia: purchase, generate_lead, sign_up, add_to_cart, begin_checkout. Para cada um, monitore volume absoluto, volume relativo (eventos/sessão), taxa de conversão do passo anterior e presença de parâmetros críticos (transaction_id, value, currency, item_id).
Alertas secundários cobrem infraestrutura de coleta: queda abrupta de page_view, pico de (not set) em dimensões-chave, ausência de client_id/user_id em eventos logados e divergência client-side vs server-side quando existir réguas. Um alerta bom tem baseline, limiar e contexto — não dispara a cada oscilação de fim de semana.
- Volume zero ou queda >30–50% vs baseline de 7/28 dias
- Conversão de funil principal fora do intervalo esperado
- Parâmetro obrigatório ausente em >5% dos hits
- Spike de (not set) após deploy GTM ou release de site
- Divergência purchase GA4 vs backend acima do SLA
- Evento duplicado ou inflado (double firing pós-mudança)
Como definir baseline e limiares que não viram ruído?
Use janelas móveis (7 dias, 28 dias) com exclusão de datas conhecidas (Black Friday, outage). Separe dia da semana e horário quando o negócio é sazonal intradiário. Limiares fixos (“alerta se purchase < 100”) falham em crescimento orgânico; percentis e desvio padrão funcionam melhor em operações maduras.
Documente exceções: campanha viral, mudança de preço, indisponibilidade de checkout. Sem registro de contexto, o time ignora alertas — e quando um real chega, ninguém reage. Um runbook por tipo de alerta (volume, conversão, parâmetro, divergência server) acelera triagem.
| Tipo de alerta | Métrica | Baseline sugerida | Ação típica |
|---|---|---|---|
| Volume zero | purchase / lead por hora | Média horária DOW | Checar GTM publish, checkout, CMP |
| Queda relativa | eventos/sessão | Média 7d excl. outliers | Diff GTM, release, tag bloqueada |
| Parâmetro ausente | % hits sem value/currency | <1% histórico | Revisar dataLayer e trigger |
| Funil quebrado | CVR step N→N+1 | Banda 28d | Validar seletor, SPA route |
| Divergência server | GA4 vs orders API | SLA acordado (ex. 95%) | Escalar backend + analytics |
Quais ferramentas usar sem montar um data center?
Camada leve: alertas nativos GA4 (quando disponíveis), Looker/BQ scheduled queries com e-mail/Slack, e monitoramento de GTM via API + changelog de versões. Camada média: ObservePoint, DataTrue, ou scripts custom que batem páginas críticas e validam dataLayer.
Para mid-market, a combinação GA4 + export BigQuery + query agendada costuma ser suficiente. O investimento pesado em RUM/APM só se paga quando o site é app-like, checkout é frágil ou o custo de outage supera o tooling. Escolha ferramenta pelo workflow do time — alerta que ninguém vê é decoração.
Como integrar monitoramento ao fluxo de deploy?
Todo publish GTM ou release de tracking deve ter: (1) checklist de Preview em URLs representativas; (2) janela de observação pós-deploy (2–24h) com alertas sensibilizados; (3) owner on-call de analytics ops. Rollback de container GTM precisa ser ritual — não heroísmo.
Conecte monitoramento a data contracts: se engenharia muda schema do dataLayer, alertas de parâmetro disparam antes do marketing perceber. Versionamento de container + tag de ambiente (staging vs prod) reduz surpresa. CI/CD de site com teste de dataLayer (Playwright + assert) fecha o ciclo.
- Checklist pós-publish com URLs de funil e conversão
- Alertas temporariamente mais sensíveis nas 24h pós-release
- Owner e canal Slack/email único para regressão de tag
- Rollback documentado de versão GTM
- Teste automatizado de dataLayer no pipeline de deploy
Como operar alertas no dia a dia sem fadiga?
Consolide alertas em um canal (#analytics-alerts), com severidade (P1 receita, P2 funil, P3 higiene). P1 exige resposta em horas e escalação; P3 pode ir para fila semanal. Revise mensalmente falsos positivos e ajuste limiares — alerta ignorado é pior que nenhum alerta.
Registre incidentes: causa raiz, tempo até detecção, tempo até correção, impacto estimado em mídia/relatório. Esse histórico justifica investimento em server-side, QA automatizado ou headcount. Analytics ops maduro mede MTTD e MTTR de regressão de tag, não só “quantos alertas”.
Quando escalar de alertas simples para observabilidade completa?
Escale quando: múltiplas fontes de verdade (client, server, CRM) divergem com frequência; releases diários; equipes distribuídas sem QA centralizado; ou receita digital materialmente afetada por outages de tracking. Aí entram réguas automatizadas, synthetic monitoring e dashboards de saúde de coleta.
Não escale prematuramente: 15 alertas mal calibrados geram mais dano que três bem escolhidos. Comece pelo funil de receita, prove valor em detecção precoce, depois expanda para eventos de produto e integrações ads. Proporcionalidade é regra de mid-market.
Checklist prático
- Lista priorizada de eventos e parâmetros críticos documentada
- Baselines e limiares por evento com exclusões sazonais
- Alertas de volume zero e queda relativa configurados
- Validação de parâmetros obrigatórios (value, currency, transaction_id)
- Canal único de alertas com severidade e runbook
- Janela pós-deploy com observação reforçada
- Régua GA4 vs backend para purchase/lead quando aplicável
- Revisão mensal de falsos positivos e incident log
Erros comuns
- Alertar só page_view e ignorar eventos de conversão
- Limiar fixo que não acompanha crescimento do site
- Publicar GTM em sexta sem observação ou rollback plan
- Enviar alertas para e-mail individual que sai de férias
- Tratar queda de conversão como problema de mídia sem checar tag
- Monitorar 200 eventos e ninguém priorizar os 5 que importam
Tag quebrada descoberta no fim do mês?
A DataScroll implementa monitoramento e alertas de tagueamento para regressões aparecerem em horas — não em semanas.