Qualidade de dados em pipelines de analytics: checks que importam
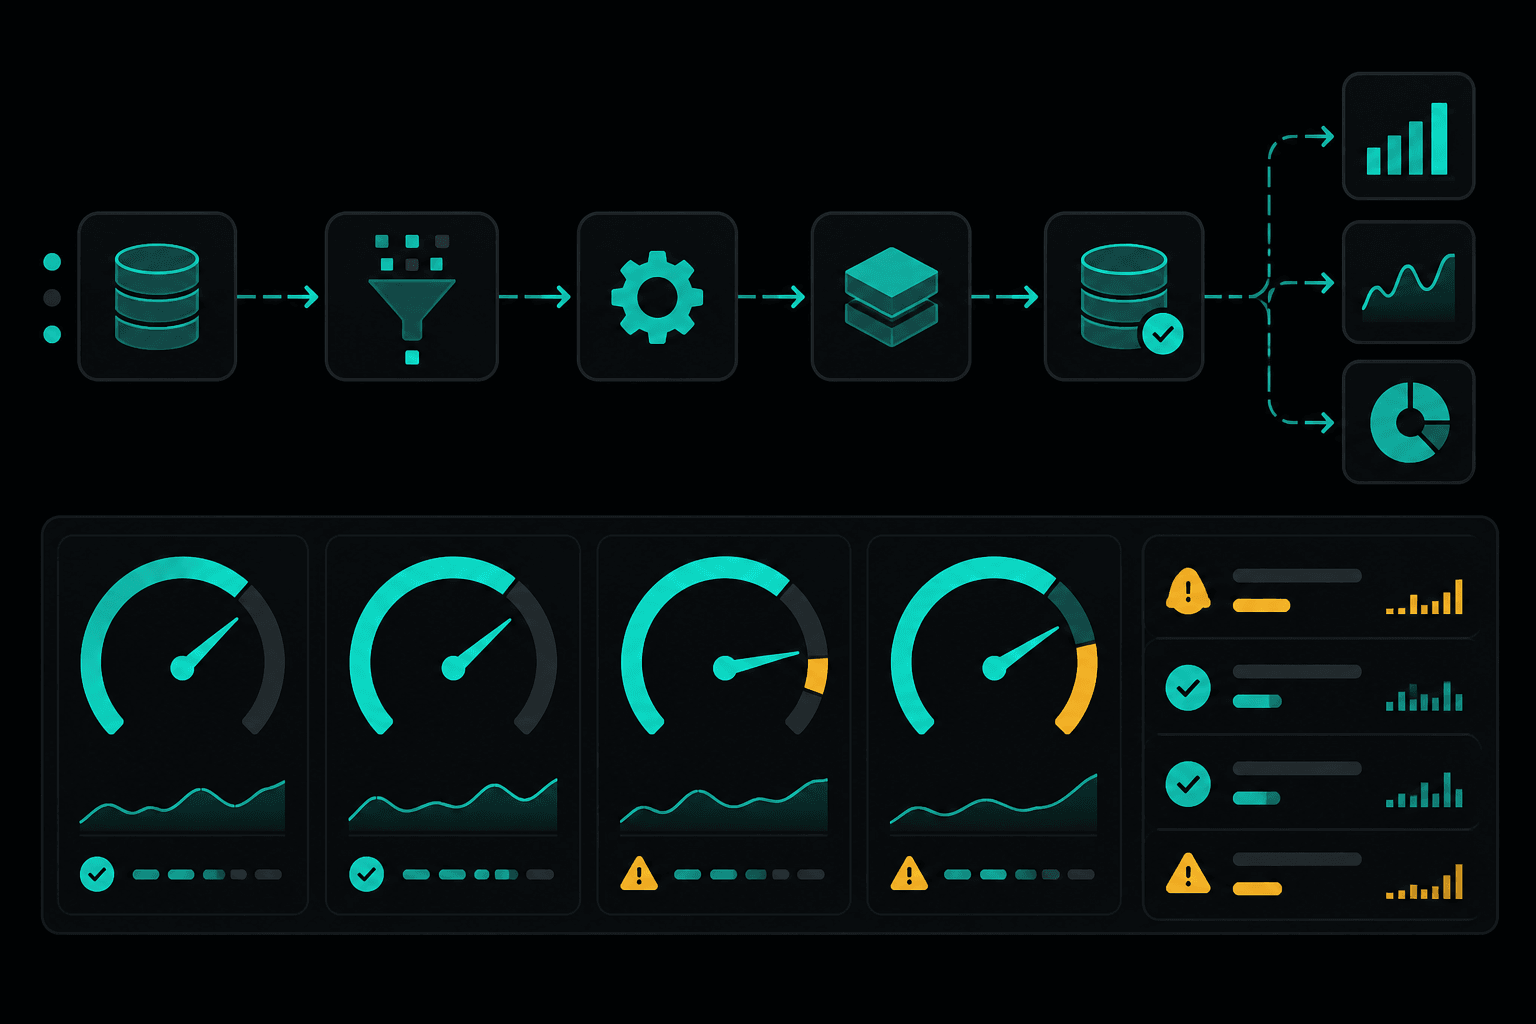
Pipeline que entrega dado atrasado, incompleto ou duplicado não é melhor que ausência de pipeline — é pior, porque gera confiança falsa. Qualidade de dados em analytics de marketing não é projeto único de limpeza; é conjunto de checks contínuos em freshness, completude, unicidade e reconciliação que impedem decisão de budget em número quebrado. O objetivo não é perfeição estatística — é detectar regressão antes do meeting de performance.
Por que data quality em marketing é diferente de outros domínios?
Dados de marketing são voláteis por natureza: campanhas ligam e desligam, UTMs mudam, tags quebram com deploy, APIs de ads atrasam, GA4 recalcula sessões. A qualidade não é estado estático — é faixa aceitável que oscila com operação. Checks devem entender sazonalidade (fim de semana cai, Black Friday dispara) e contexto (campanha pausada = zero spend esperado).
Além disso, múltiplas fontes precisam concordar: spend no warehouse vs plataforma de ads; conversões no GA4 vs CRM vs pixel. Qualidade em marketing é reconciliação cross-fonte tanto quanto validade de schema.
Quais dimensões de qualidade importam para pipelines de analytics?
Freshness: dado chegou no SLA? Spend de ontem disponível às 8h? Completude: volume esperado vs recebido — queda de 40% em eventos GA4 indica tag quebrada, não ‘terça-feira lenta’. Unicidade: grain respeitada — duplicata de lead ou sessão infla métricas. Validade: valores dentro de taxonomia — channel=’facebook’ vs ‘Facebook Ads’ vs NULL.
Consistência: mesma métrica, mesma definição, mesma janela em dashboard e warehouse. Reconciliação: totais batem com fonte de origem dentro de tolerância. Accuracy é a mais difícil — often proxy via reconciliação.
- Freshness: SLA por source (ads T+1 8h, GA4 T+1 6h)
- Completude: volume vs média móvel 7d/28d
- Unicidade: unique tests na grain da fato
- Validade: accepted_values em dimensões
- Reconciliação: warehouse vs API plataforma
Quais checks implementar primeiro?
Priorize o que dói quando quebra: (1) freshness de spend e conversões — decisão diária de mídia depende; (2) reconciliação spend warehouse vs Google/Meta Ads; (3) volume de eventos GA4 vs média móvel — tag quebrada; (4) conversion count > 0 em dias úteis — conversão zerada é red flag; (5) unique session_id/lead_id na fato.
Não implemente 200 checks no dia 1. Comece com 5-8 críticos, tune thresholds por 2 semanas observando falsos positivos, expanda. Check que alerta todo dia virando ruído é pior que nenhum check.
| Check | Métrica | Threshold típico | Ação se falhar |
|---|---|---|---|
| Freshness spend | max(date) na fato | Ontem disponível até 8h | Escalar ingestão |
| Volume GA4 | count events vs avg 7d | Queda >30% | Verificar GTM/tag |
| Reconciliação spend | BQ vs Ads API | Divergência >2% | Auditar transform |
| Conversão zero | conversions ontem | 0 em dia útil | Verificar pixel/evento |
| Duplicata lead | unique lead_id | duplicates >0 | Auditar dedupe CRM |
Como implementar checks: dbt, Great Expectations ou custom?
dbt tests (schema tests + singular tests SQL) cobrem 80% das necessidades mid-market — integrados ao pipeline, falham o run, documentados. Great Expectations ou Soda adicionam profiling e checks mais ricos se necessário. Scripts custom com alertas Slack/email funcionam para começar.
Onde o check roda importa menos que o check existir e alguém receber alerta acionável. dbt test failure → Slack #data-alerts com owner @analytics-engineer. Não email genérico que ninguém lê.
Como calibrar thresholds sem alerta falso constante?
Use média móvel e desvio padrão em vez de threshold fixo: alerta se volume < μ – 2σ da média 28d. Exclua feriados e eventos conhecidos (Black Friday) de baseline. Para spend, tolerância de 1-2% em reconciliação absorve arredondamento de API.
Tune empiricamente: primeiras 2 semanas, log warnings sem pager. Ajuste threshold até falsos positivos <1/semana. Documente exceções: ‘campanha X pausada em 15/03 — suprimir alerta spend zero’.
Qual rotina operacional sustenta qualidade?
Daily: review automático de checks críticos (freshness, volume, reconciliação). Weekly: data quality dashboard com trend de métricas de qualidade (% unattributed, duplicatas, lag). Monthly: auditoria manual de amostra — 10 campanhas reconciliadas manualmente, 50 leads verificados ponta a ponta.
Incident response: quando check falha, runbook claro — quem investiga, em quanto tempo, como comunicar marketing (‘número de ontem incompleto, não usar para decisão’). Post-mortem quando regressão chegou ao dashboard antes do alerta.
- Runbook por tipo de falha (tag, API, transform)
- Owner on-call rotativo para data quality
- Comunicação proativa ao marketing quando dado suspeito
- Post-mortem sem culpa — melhorar checks
- Dashboard de qualidade visível ao time
Como medir ROI de data quality?
Difícil quantificar, fácil sentir: quantas decisões erradas evitadas, quantas horas de reconciliação manual eliminadas, quanto tempo entre tag quebrada e detecção (horas vs semanas). KPI operacional: MTTD (mean time to detect) e MTTR (mean time to resolve) de incidentes de dados.
Compare trimestre com checks vs trimestre anterior sem: incidentes reportados por marketing, retrabalho de relatórios, budget deslocado por número errado. Mesmo um caso de ‘pausamos campanha boa porque conversão zerou por bug’ justifica investimento.
Checklist prático
- 5-8 checks críticos implementados (freshness, volume, reconciliação)
- Thresholds calibrados com baseline de 2 semanas
- Alertas Slack/email com owner definido
- Runbook de incident response documentado
- dbt tests ou equivalente integrados ao CI/CD
- Dashboard de qualidade com trends
- Rotina weekly de review de checks
- Comunicação clara ao marketing quando dado incompleto
Erros comuns
- 200 checks no dia 1 — alert fatigue garantida
- Threshold fixo ignorando sazonalidade e feriados
- Check falha sem owner nem runbook
- Reconciliar só spend e ignorar conversões/CRM
- Data quality como projeto único, não operação contínua
- Alerta por email que ninguém monitora
Decisão tomada em dado quebrado?
A DataScroll implementa checks de qualidade e alertas nos pipelines para o time confiar no número antes do meeting.