
Custo de consulta: partição, cluster e limite
Custo de consulta depende do que a query precisa ler. Partição e cluster existem para a pergunta do dia não varrer o histórico inteiro.
Custo de consulta depende do que a query precisa ler. Partição e cluster existem para a pergunta do dia não varrer o histórico inteiro.
Ambientes de dados existem para testar transformação sem ler o cadastro real. Produção fica fechada. Dev usa amostra ou dado sintético.
Captura de mudanças serve quando a tabela cresceu e o full extract não cabe na janela. Update e delete precisam entrar no desenho, não só a linha nova.
Testes de pipeline rodam antes da troca da tabela que alguém lê. Volume, formato e uma soma de controle evitam publicar a carga pela metade.
Backfill de pipeline serve para corrigir o histórico. Sem chave e sem janela fechada, o reprocesso duplica o mês que a reunião já viu.
Observabilidade de pipeline é saber se o dado chegou na hora, no volume esperado e com o formato combinado.
Na integração com ERP, o BI lê o documento que o fiscal gravou. Ajuste de apresentação não reescreve a nota.
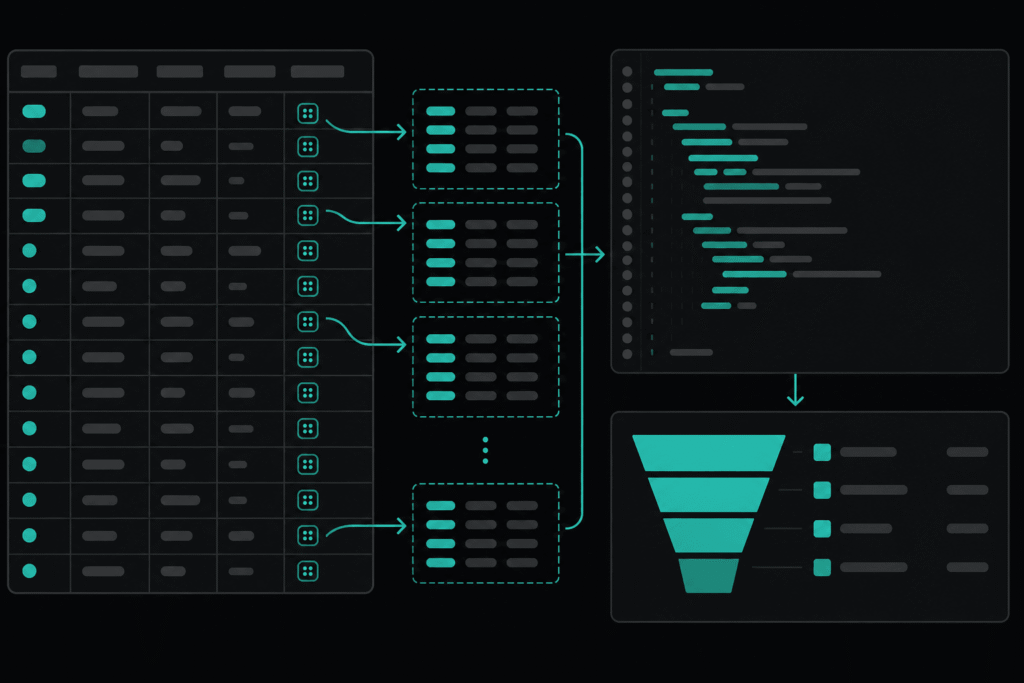
SQL prático no export GA4 BigQuery: eventos, parâmetros unnest, funis, receita e queries que a UI não entrega.
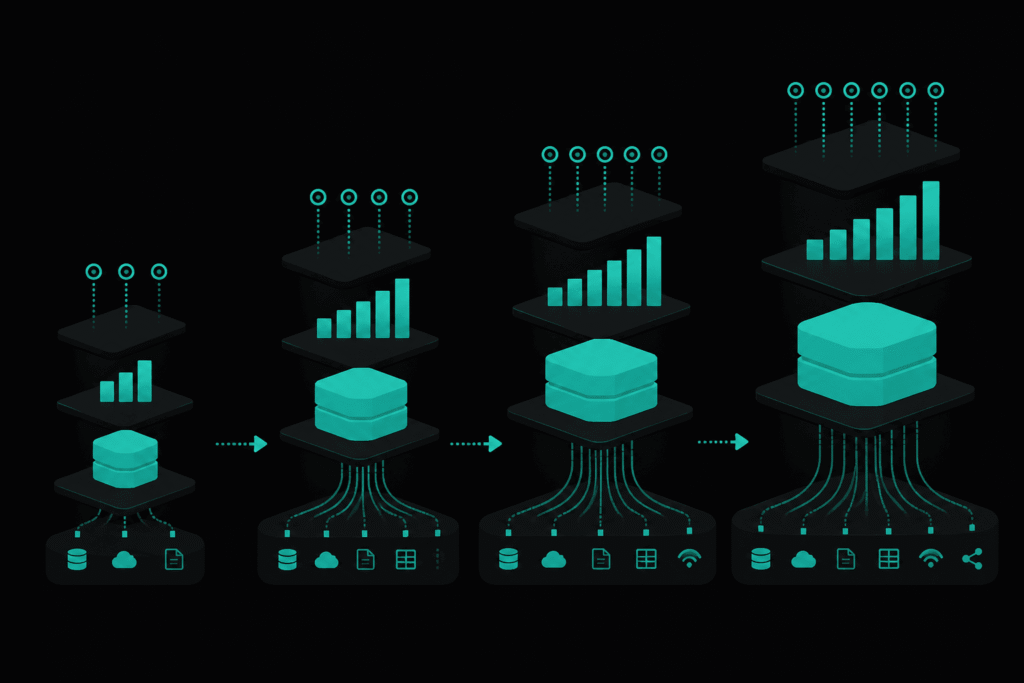
Arquitetura de dados mid-market: fontes, warehouse, BI, reverse ETL, custos e evolução por estágio sem comprar tudo de uma vez.
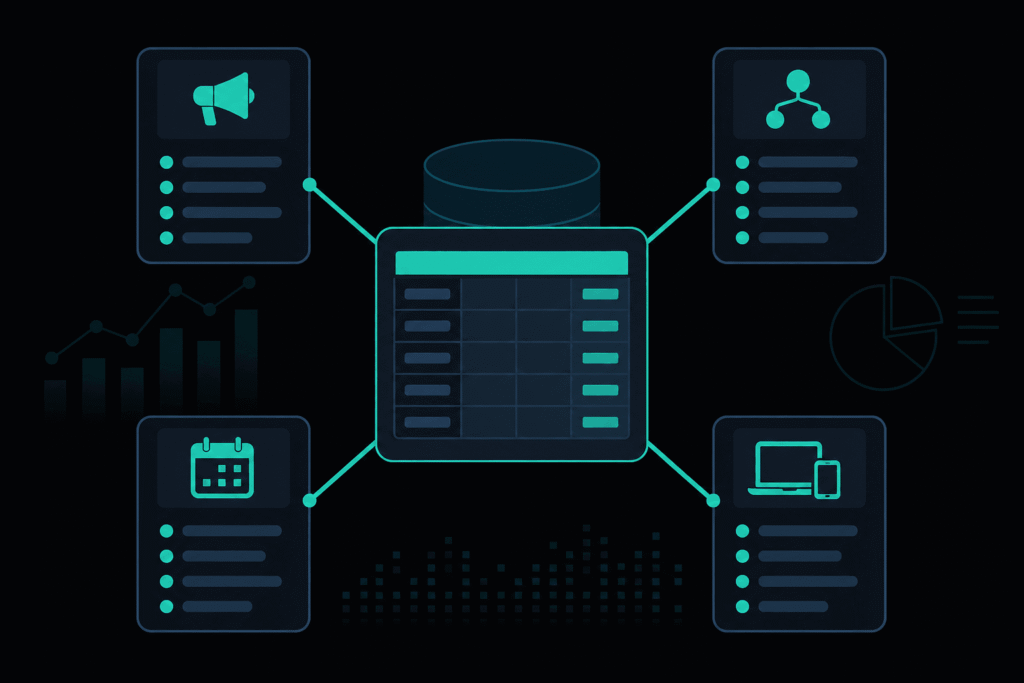
Como modelar dados de marketing em star schema: fatos, dimensões, granularidade e erros que quebram dashboards.